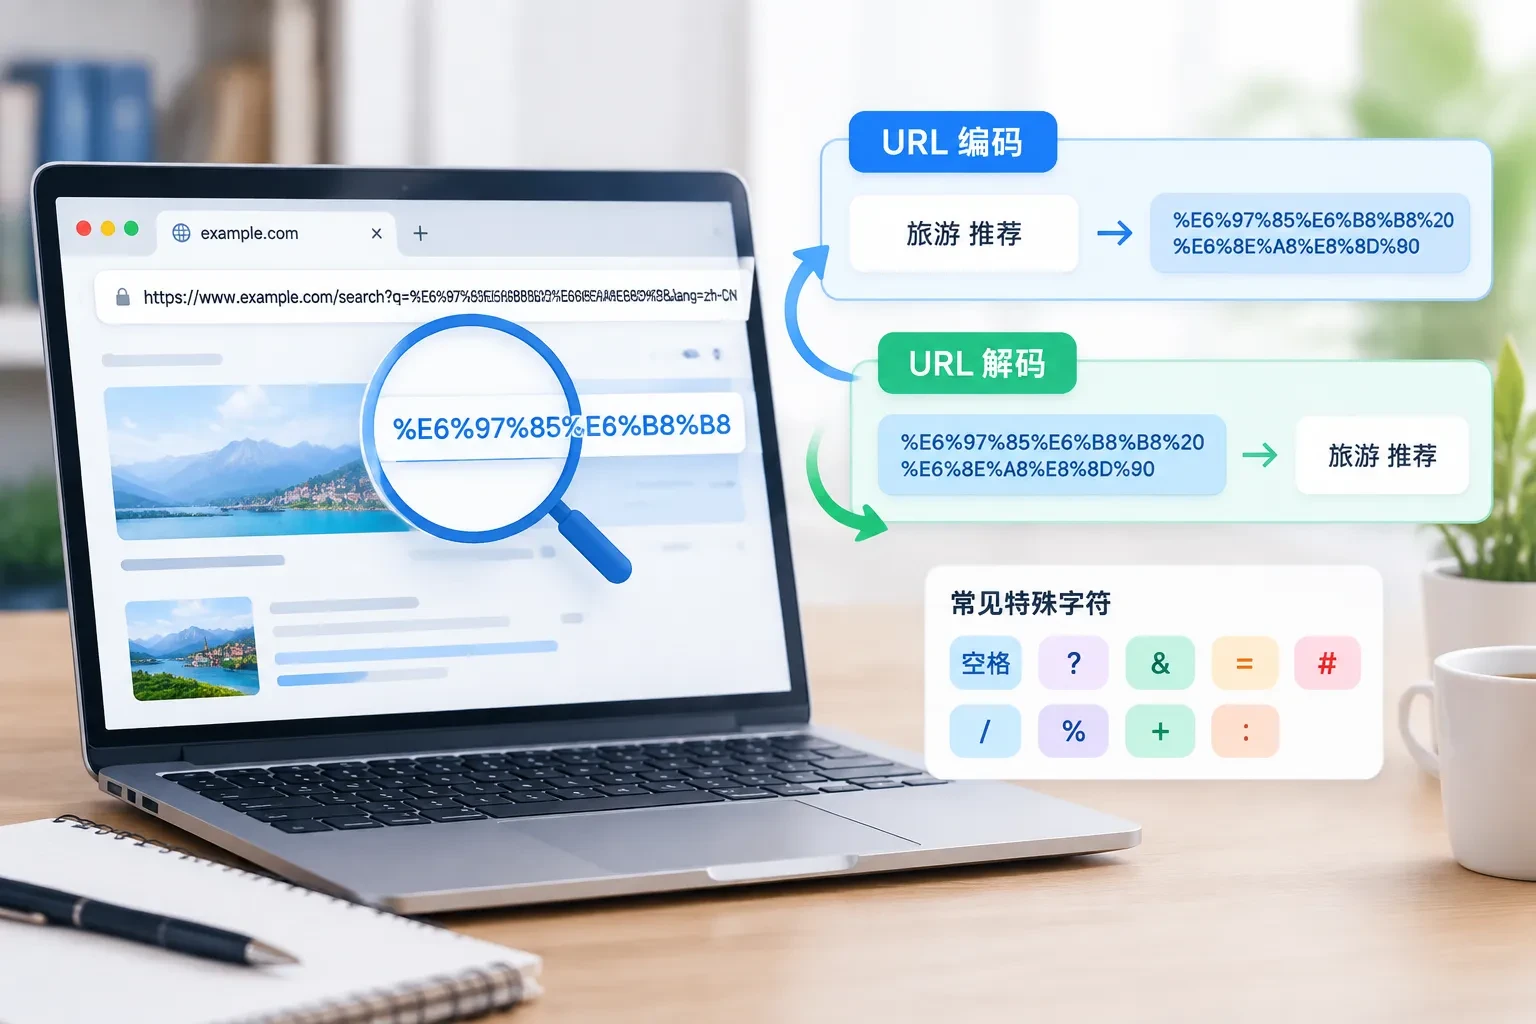
在浏览网页或编写 API 请求时,我们经常会在浏览器地址栏看到形如 https://example.com/search?q=%E6%98%93%E5%A4%84%E7%90%86&category=pdf 这样夹杂着大量百分号 % 的 URL 路径。这就是网络协议中标准的URL 百分号编码(Percent-Encoding / URL Encode)。
本文将为你详解为什么 URL 不能直接传递中文和特殊符号、加号 + 与空格 %20 的历史遗留坑,以及如何使用易处理在线工具快速还原参数内容。
1. 为什么 URL 中必须进行编码?
根据互联网工程任务组制定的 RFC 3986 规范,统一资源标识符(URI)中只允许包含有限的字符集合:
- 非保留字符(可直接使用):英文字母(
A-Z, a-z)、数字(0-9)、短划线-、下划线_、英文点.和波浪线~; - 保留字符(具有协议特殊语法语义):如问号
?表示查询参数起点、与号&用于分隔多个参数、斜杠/表示路径层级、等号=绑定键值。
当我们要传递的数据本身就包含保留符号(例如搜索词是 C++ & Java)或多字节的中文时,如果直接拼进 URL,浏览器和服务器就无法区分这些符号到底属于“数据本身”还是“协议语法”,因此必须将非安全字符全部转义为 %XX 十六进制格式。
2. 常见特殊字符的 URL 编码对照表
| 字符 | 编码后格式 | 常见问题场景 |
|---|---|---|
| 空格(Space) | %20 或 + |
表单提交默认将空格转为 +,而标准规范中应为 %20 |
与号 & |
%26 |
若不转义,会被后端路由误识别为新参数的分隔符 |
等号 = |
%3D |
若作为参数值(如加密密文),不转义会导致键值解析错乱 |
问号 ? |
%3F |
会截断或篡改正常的 QueryString 起始位置 |
井号 # |
%23 |
会导致后面的字符全部被当作浏览器前端锚点(Hash),后端根本收不到数据 |
3. 前端开发者必知:encodeURI 与 encodeURIComponent 的差异
JavaScript 原生提供了两个编码函数,使用错误会导致严重 Bug:
const keyword = "https://yichuli.com?tag=C++&type=pdf";

// ① encodeURI: 用于给整个完整 URL 编码,不会转义 : / ? # & = 等保留字符
console.log(encodeURI(keyword));
// 输出: https://yichuli.com?tag=C++&type=pdf (注意: & 和 + 仍未转义,作为参数传递依然会出错)

// ② encodeURIComponent: 用于给单个参数值编码,会把除字母数字外几乎所有符号全部转义
console.log(encodeURIComponent(keyword));
// 输出: https%3A%2F%2Fyichuli.com%3Ftag%3DC%2B%2B%26type%3Dpdf (安全嵌入作为其他 URL 的参数)行业黄金准则:对拼接在?key=后面的每一个独立参数值,务必使用encodeURIComponent单独编码!
4. URL 参数乱码与“二次编码”问题
在跨系统跳转(如 OAuth2 授权回调、支付重定向)中,经常出现参数被二次转义,导致解码一次后仍然显示为 %25E4%25BD... 的情况。此时你会发现百分号 % 本身又被转成了 %25。解决方法是连续执行两次解码,或者在发送前确保只由发起端做一次完整编码。
5. 在线快速解码与排错
在审查抓包数据或重定向链接时,可以直接在易处理 URL解码工具中粘贴混乱的参数文本,工具会即时还原为纯净易懂的中文和原文符号,同时提供对应的 URL在线编码 功能,满足全场景调试需求。